지난번과 이번의 유형 이름이 다르면, 결과표보다 자신을 먼저 의심하기 쉬워요. ‘내 성향이 달라진 걸까’, ‘어느 쪽이 진짜일까’라는 질문이 생기죠. 하지만 결과가 달라졌다는 사실과, 사람이 달라졌다는 해석은 별개예요. 같은 답을 다른 방식으로 계산했을 수도 있고, 비슷한 점수가 분류선의 반대편으로 넘어갔을 수도 있어요. 차이를 설명하려면 이름표 뒤에 있는 점수와 측정 조건부터 구분해야 해요.
BDSM 유형 검사처럼 개인적인 관심과 성향을 분류하는 결과도 예외가 아니에요. 온라인 결과표의 한계는 온라인 성향 분류와 심리검사의 차이에서 다뤘어요. 여기서 더 따져볼 문제는 ‘믿을 만한 검사인가’라는 큰 질문보다 좁아요. 두 번의 결과 사이에 무엇이, 얼마나 달라졌으며, 그 차이를 어떤 근거로 해석할 수 있는가예요.
숫자가 붙으면 해석도 정확해 보이지만, 숫자만으로는 비교 기준이 생기지 않아요. 결과가 2점 달라졌다는 말에는 점수의 단위, 계산 방식, 오차의 크기가 빠져 있을 수 있어요. 반대로 유형 이름이 그대로라는 이유만으로 모든 응답이 같았다고 볼 수도 없죠. 결과의 반복성, 점수 차이의 의미, 유형 구분의 안정성을 나눠 보면 이 혼동을 줄일 수 있어요.
같은 검사라는 이름보다, 같은 조건인지가 먼저예요
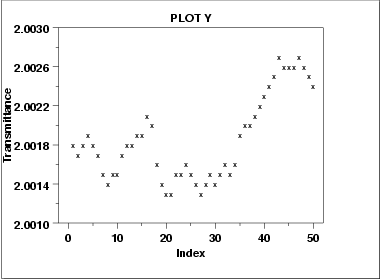
이 그림은 NIST의 물리적 측정 자료를 순서대로 놓은 예시예요. 마지막 구간에서 값의 중심이 높아지는 모습이 보이죠. 점들을 한데 모은 평균만 보면 놓칠 수 있는 변화예요. NIST는 이런 순서도표로 값의 중심이나 흩어짐이 일정한지 살펴볼 수 있다고 설명해요. 다만 이 그림은 사람의 성향이나 BDSM 검사 결과를 조사한 자료가 아니에요. 측정값에는 순서와 조건이라는 맥락이 있다는 점을 보여 주는 통계 예시예요. [NIST 순서도표]
가령 공부 습관을 묻는 가상의 설문 두 개가 있다고 해 볼게요. 하나는 ‘지난 일주일에 계획을 지켰는가’를, 다른 하나는 ‘평소 계획적인 사람인가’를 물어요. 둘 다 계획성이라는 제목을 붙일 수 있지만, 응답자가 떠올려야 하는 시간 범위가 달라요. 시험이 있었던 한 주에 대한 답과 평소의 자기평가는 같은 대상을 똑같이 측정한 두 번의 기록이 아니에요. 점수 차이를 전부 성격 변화로 돌리면 질문의 차이를 사람의 변화로 잘못 읽게 되죠.
계산 방식이 달라도 비슷한 혼동이 생겨요. 첫 결과는 10문항의 합계이고, 다음 결과는 그중 일부에 더 높은 비중을 줬다면, 응답이 같아도 최종 점수는 달라질 수 있어요. 문항이 줄거나 번역 표현이 바뀐 경우에도 단순히 같은 이름이 붙어 있다는 이유만으로 직접 비교할 수는 없어요. 비교가 가능한지에 관한 설명이 먼저 필요하다는 뜻이지, 변경된 검사는 모두 나쁘다는 뜻은 아니에요.
AERA·APA·NCME의 교육 및 심리검사 표준은 타당성을 검사에 붙이는 포괄적인 인증처럼 취급하지 않아요. 특정한 점수 해석과 사용 목적을 뒷받침하는 근거가 있어야 한다고 요구해요. 한 집단, 한 버전에서 얻은 근거를 다른 상황에 그대로 옮기는 데에도 설명이 필요하죠. ‘성향을 측정한다’는 문구보다 어떤 성향을, 누구에게, 어떤 방식으로 해석하려는가가 더 구체적인 질문이에요. [검사 표준 1.0·1.1·2.9]
이 구분을 결과표 두 장에 적용하면 판단이 달라져요. ‘둘 다 같은 사이트에서 나온 결과다’까지는 확인할 수 있어도, 문항·채점·점수 단위가 같다는 정보가 없으면 변화량의 의미는 남겨 두어야 해요. 60에서 65로 올랐다는 숫자는 계산할 수 있지만, 그 5가 무엇의 5인지까지 계산해 주지는 않아요. 동일한 항목명과 동일한 측정은 서로 다른 조건이에요.
여기서 신뢰도와 타당도의 차이도 드러나요. 매번 비슷한 결과가 나온다는 것은 반복성에 관한 단서예요. 그것이 곧 결과표에 적힌 성향을 제대로 설명한다는 근거는 아니죠. 눈금이 일정하게 잘못 표시된 자도 같은 물체를 반복해서 비슷하게 읽을 수 있어요. 이 비유의 요점은 모든 설문이 잘못됐다는 데 있지 않아요. 흔들림이 작다는 질문과, 해석이 맞는다는 질문을 따로 해야 한다는 데 있어요.
상관이 높아도, 내 점수가 그대로라는 뜻은 아니에요
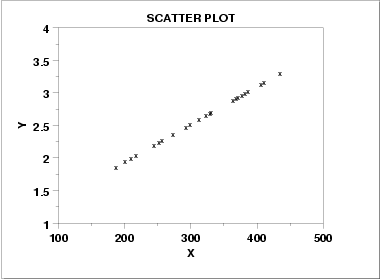
NIST의 이 산점도에서는 점들이 오른쪽 위로 향하는 직선 위에 놓여 있어요. 두 값 사이의 선형 관계가 매우 규칙적이라는 모습이에요. 하지만 ‘한 값이 커지면 다른 값도 일정하게 커진다’와 ‘두 값이 서로 같다’는 다른 문장이에요. [NIST 선형 관계 예시]
간단한 계산으로 확인할 수 있어요. 아래는 실제 연구 결과가 아니라, 관계와 일치의 차이를 보이기 위해 만든 가상의 학습 습관 점수예요. 두 번째 점수에는 모두 5점을 더했어요.
| 대상 | 첫 점수 | 둘째 점수 | 차이 |
|---|---|---|---|
| 가 | 10 | 15 | +5 |
| 나 | 20 | 25 | +5 |
| 다 | 30 | 35 | +5 |
가보다 나가 높고, 나보다 다가 높다는 순서는 그대로예요. 둘째 점수는 첫 점수에 일정한 수를 더한 것이므로 이 예시의 피어슨 상관계수는 1이에요. 그렇지만 세 사람 가운데 점수가 같게 나온 사람은 없어요. 평균도 20에서 25로 바뀌었죠. ‘상관이 완벽하다’는 말이 ‘모든 사람의 값이 일치한다’는 말은 아니라는 반례예요.
Bland와 Altman은 두 측정 방법을 비교한 방법론 논문에서 이 차이를 지적했어요. 높은 상관만으로 측정값의 일치를 판단하면 안 된다는 거예요. 두 값이 얼마나 함께 움직이는지뿐 아니라 실제로 얼마나 차이 나는지를 살펴야 해요. 이 논문은 임상 측정 방법의 비교를 다룬 것이며, 특정 온라인 성향 검사의 성능을 검증한 연구는 아니에요. 여기서 가져올 수 있는 것은 상관과 일치를 혼동하지 않는 측정의 원칙이에요. [Bland·Altman, 1986]
따라서 검사 설명에 ‘재검사 상관이 높다’는 문장이 있더라도, 그 한 문장으로 개인의 점수가 몇 점까지 달라질 수 있는지는 알 수 없어요. 여러 사람 사이의 상대적인 차이가 잘 유지되는 것과, 한 사람의 값이 좁은 범위에서 반복되는 것은 함께 살펴볼 수 있지만 같은 질문은 아니에요. 집단을 요약한 숫자를 개인에게 그대로 붙이면 이 단계가 생략돼요.
크론바흐 알파도 이름만 보고 같은 답으로 취급하기 쉬워요. 알파는 한 번 얻은 여러 문항의 응답 관계에서 계산하는 지표이며, 문항 수와 문항 사이의 관련성 등에 영향을 받아요. 값이 높다는 것만으로 시간이 지나도 결과가 똑같거나, 문항들이 오직 하나의 특성만 측정한다고 결론 내릴 수 없어요. Tavakol과 Dennick의 설명도 알파를 비판 없이 해석하지 말라고 강조해요. [Tavakol·Dennick, 2011]
‘신뢰도 0.9’라는 표현을 봤다면 그래서 뒤의 설명이 중요해져요. 문항 사이의 관계를 말하는지, 시간 간격을 두고 얻은 점수의 관계를 말하는지, 서로 다른 평가자의 일치를 말하는지에 따라 질문이 달라요. 이를 구분하지 않고 ‘90% 정확한 검사’나 ‘내 결과가 맞을 확률 90%’로 바꾸면 원래 지표에 없던 의미를 덧붙이게 돼요. 숫자가 같아 보여도 확률의 대상과 계산 방식이 같다는 보장은 없어요.
2점의 차이가 큰지 작은지는, 오차 정보가 있어야 알아요
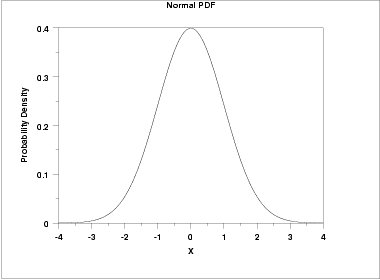
종 모양의 곡선을 보면 ‘사람의 성향도 이렇게 분포하겠지’라고 생각하기 쉽지만, 이 그림은 평균 0·표준편차 1인 수학적 분포예요. NIST는 정규분포를 가정하는 통계 방법을 적용할 때 그 가정이 자료에 맞는지 확인해야 한다고 설명해요. 모든 심리 점수, 모든 측정오차가 이 모양이라고 정해 놓을 수는 없어요. [NIST 정규분포]
‘점수가 달라졌다’는 사실을 해석할 때도 먼저 필요한 것은 그 검사에 맞는 오차 정보예요. 측정의 표준오차는 점수의 정밀도를 점수 단위로 표현하는 데 쓰여요. 검사 표준은 개별 점수와 점수 차이를 해석할 때 그에 맞는 정밀도 근거를 요구하고, 필요하면 점수대별 정보도 제시하도록 해요. 전체 집단에 관한 신뢰도 한 개가 모든 개인과 모든 점수 구간의 정밀도를 대신하는 것은 아니에요. [검사 표준 2.4·2.13·2.14]
예를 들어 가상의 결과표에서 55점이 57점이 됐다고 해 볼게요. 차이는 분명히 2점이에요. 그러나 채점 방식이 공개되지 않았다면, 한 문항의 선택이 바뀐 것인지 여러 문항이 조금씩 달라진 것인지도 알기 어려워요. 오차 정보까지 없다면 그 2점이 측정 과정에서 흔히 생길 수 있는 범위인지, 따로 설명할 만한 변화인지 판단할 재료가 부족해요. 차이를 계산할 수 있다는 것과, 차이를 해석할 수 있다는 것은 달라요.
소수점이 길게 붙어도 사정은 같아요. 결과가 55.37점으로 표시됐다는 사실은 화면이 두 자리까지 출력한다는 뜻일 수 있어요. 그 자체로 55.36과 55.37을 심리적으로 구별할 만큼 정밀하다는 증거는 아니죠. 계산기의 표시 자릿수와 측정 도구의 정밀도를 혼동하면, 의미가 확인되지 않은 작은 차이에 긴 설명을 붙이게 돼요.
그렇다고 독자가 임의로 ‘대략 ±5점쯤은 오차겠지’라고 정하면 문제가 해결되는 것은 아니에요. 다른 설문에서 보고한 오차를 가져오거나, 인터넷에서 본 신뢰도 숫자에 맞춰 구간을 만들면 그럴듯한 숫자가 하나 더 생길 뿐이에요. 검사 버전, 점수 단위, 조사 대상이 다른데도 같은 오차를 가정할 근거가 없기 때문이에요. 이때의 정확한 결론은 ‘차이가 없다’가 아니라 현재 정보로는 그 차이의 크기를 해석하기 어렵다예요.
오차와 실제 변화는 양자택일도 아니에요. 질문의 의미를 다르게 이해했거나, 떠올린 시기가 달랐거나, 실제 생각의 변화가 있었을 가능성을 각각 검토할 수 있어요. 다만 결과표 두 장만으로 원인별 몫을 나눌 수는 없어요. ‘이번 답이 달랐다’는 관찰에서 곧바로 ‘본래 성향이 바뀌었다’는 설명까지 건너뛰지 않는 것이 중요해요.
이를 일상적인 언어로 바꾸면 ‘내가 이상해서 결과가 흔들린다’보다 ‘이 도구와 이 조건에서 나온 기록이 달랐다’에 가까워요. 후자는 측정한 사실을 말하고, 전자는 사람 전체에 평가를 붙여요. 자료가 제공하지 않은 평가를 스스로 떠안을 필요는 없어요. 결과표의 불확실성을 인정하는 것은 자기 이해를 포기하는 일이 아니라, 작은 기록이 설명할 수 있는 범위를 넘기지 않는 일이에요.
유형 이름은 경계에서 바뀌고, 사람에 대한 판단은 남을 수 있어요
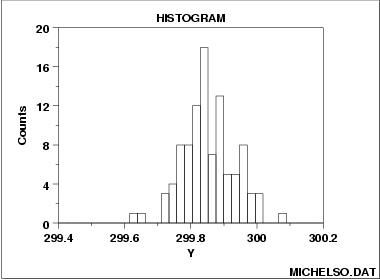
이 히스토그램은 미켈슨의 광속 측정 자료를 일정한 구간으로 나누어 빈도를 보여 줘요. 막대의 경계는 자료를 묶어 표시하는 장치예요. NIST의 설명처럼 구간은 정해진 규칙으로도, 사용자가 선택한 방식으로도 만들 수 있어요. 여기서 막대가 여러 개라는 사실이 측정 대상에 그만큼의 본질적인 종류가 있다는 뜻은 아니에요. [NIST 히스토그램]
온라인 유형 분류도 숫자를 이름으로 바꾸는 과정이 있다는 점에서 경계를 따져 볼 필요가 있어요. 가상의 학습 습관 분류가 50점 미만을 가형, 50점 이상을 나형이라고 부른다고 해 볼게요. 49점에서 51점이 되면 이름이 바뀌어요. 반면 20점에서 40점이 되면 이름은 그대로예요. 앞의 변화는 2점이고 뒤는 20점인데, 이름만 보면 앞쪽에서 더 큰 사건이 일어난 것처럼 보이죠.
이 예시는 실제 성향 검사의 기준을 제안하는 것이 아니에요. 분류 규칙을 정하면 생기는 계산상의 결과예요. 유형의 변경 여부와 점수의 변화량은 서로 바꿔 쓸 수 없어요. 경계 가까이에 놓인 점수는 작은 차이로 다른 이름을 받을 수 있고, 같은 이름 안에서도 점수 차이가 클 수 있어요. 따라서 이름의 변경을 곧 정체성의 변경으로 읽으면 중간에 있는 분류 규칙을 빠뜨리게 돼요.
검사 표준이 분류 결과를 사용하는 검사에 분류의 일관성에 관한 근거를 요구하는 이유도 여기에 있어요. 점수의 신뢰도가 보고돼 있다는 사실만으로, 특정 경계에서 같은 판단이 얼마나 안정적으로 반복되는지까지 설명된 것은 아니에요. 이름표를 사용하려면 그 이름표를 붙이는 결정에 맞는 근거가 필요해요. [검사 표준 2.16]
비슷해 보이는 백분율에도 주의가 필요해요. ‘70%’라는 표시는 가능한 총점에 대한 비율일 수도 있고, 다른 응답자와 비교한 위치일 수도 있으며, 서비스가 별도로 정한 지수일 수도 있어요. 무엇을 분모로 삼았는지 설명이 없다면 ‘내가 이 유형일 확률이 70%’로 읽을 근거가 없어요. 두 결과를 비교하기 전에도 이 단위가 같은지 확인해야 해요. 이름 옆의 기호 하나로 계산의 의미까지 정해지지는 않아요.
자료를 읽는 독자가 요구할 수 있는 설명은 구체적이에요. 어느 버전의 문항인지, 점수와 유형이 어떻게 연결되는지, 신뢰도 지표가 무엇을 비교했는지, 개인의 점수 차이와 경계 부근의 판단에는 어떤 근거가 있는지예요. 이런 설명이 보이지 않을 때 결과가 거짓이라고 단정할 필요는 없지만, 보이지 않는 근거를 있는 것처럼 채워 넣을 이유도 없어요.
검사의 반복성을 연구하는 일과, 독자가 확신을 얻으려고 같은 검사를 계속하는 일도 구분해야 해요. 결과표의 한계를 확인하기 위해 민감한 응답이나 결과 화면을 다른 사람에게 제출할 필요는 없어요. 특히 한 장의 화면으로 누군가에게 정체성을 증명하거나, 다른 사람의 성향을 대신 결정하려 하면 검사 해석을 넘어서는 판단이 들어가요. 성향·선호·정체성과 상황을 구분하는 설명이 이 차이를 이어서 다뤄요.
결국 두 결과가 다를 때 곧바로 고를 답은 ‘첫 번째가 진짜’ 또는 ‘두 번째가 진짜’가 아니에요. 같은 측정인지 확인하고, 관계와 일치를 구분하고, 차이의 오차와 분류 경계를 살펴본 뒤에도 남는 부분은 남겨 둘 수 있어요. 결과표가 달라졌다는 관찰은 존중하되, 그것만으로 한 사람 전체에 대한 결론을 내리지 않는 것이 더 신중한 읽기예요.
근거 자료 — AERA·APA·NCME, Standards for Educational and Psychological Testing(2014), 타당도·신뢰도 및 정밀도 장; J. M. Bland·D. G. Altman, Statistical Methods for Assessing Agreement Between Two Methods of Clinical Measurement(1986); M. Tavakol·R. Dennick, Making sense of Cronbach’s alpha(2011). 통계 그림은 NIST/SEMATECH e-Handbook of Statistical Methods의 각 설명 페이지에 연결되어 있어요.
NIST 그림 출처와 이용 고지
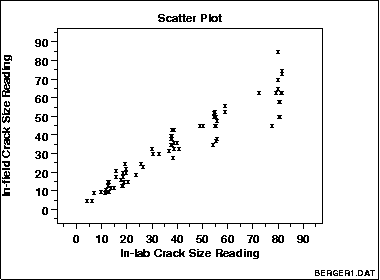
글 상단의 산점도는 알래스카 파이프라인 자료의 산점도예요. 상단 산점도와 본문의 네 그림은 NIST/SEMATECH 통계 핸드북의 자료이며, 이 글의 심리교육적 해석을 NIST가 보증하거나 특정 온라인 검사를 검증한다는 뜻은 아니에요. 원본 GIF를 2026년 10월 6일 PNG로 변환했으며 픽셀·크기·구도는 바꾸지 않았어요. NIST 자료 이용 조건과 아래 원기관 고지가 적용돼요.
This data/work was created by employees of the National Institute of Standards and Technology (NIST), an agency of the Federal Government. Pursuant to title 17 United States Code Section 105, works of NIST employees are not subject to copyright protection in the United States. This data/work may be subject to foreign copyright.
The data/work is provided by NIST as a public service and is expressly provided “AS IS.” NIST MAKES NO WARRANTY OF ANY KIND, EXPRESS, IMPLIED OR STATUTORY, INCLUDING, WITHOUT LIMITATION, THE IMPLIED WARRANTY OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE, NON-INFRINGEMENT AND DATA ACCURACY. NIST does not warrant or make any representations regarding the use of the data or the results thereof, including but not limited to the correctness, accuracy, reliability or usefulness of the data.
NIST SHALL NOT BE LIABLE AND YOU HEREBY RELEASE NIST FROM LIABILITY FOR ANY INDIRECT, CONSEQUENTIAL, SPECIAL, OR INCIDENTAL DAMAGES (INCLUDING DAMAGES FOR LOSS OF BUSINESS PROFITS, BUSINESS INTERRUPTION, LOSS OF BUSINESS INFORMATION, AND THE LIKE), WHETHER ARISING IN TORT, CONTRACT, OR OTHERWISE, ARISING FROM OR RELATING TO THE DATA (OR THE USE OF OR INABILITY TO USE THIS DATA), EVEN IF NIST HAS BEEN ADVISED OF THE POSSIBILITY OF SUCH DAMAGES.