“BDSM 참여자와 비교집단 사이에 통계적으로 유의한 차이가 나타났다”는 문장을 보면 어느 집단의 특징이 확정된 것처럼 느껴질 수 있어요. 그러나 p<.05는 “이 설명이 맞을 확률이 95%”라는 뜻도, “두 집단이 95% 다르다”는 뜻도 아닙니다. 차이가 얼마나 큰지, 결과가 어느 범위에서 흔들릴 수 있는지, 몇 개의 분석 가운데 골라 보고한 값인지도 따로 확인해야 해요.
이 글은 특정 온라인 검사를 채점하거나 사람의 성향을 판정하지 않습니다. BDSM 관련 집단 연구에서 자주 보이는 p값, 효과크기, 신뢰구간, 다중비교와 반복 연구를 서로 다른 질문으로 나누어 읽는 방법을 다룹니다. 표본과 자기보고, 상관관계의 기본 한계는 BDSM 연구 결과는 누구에게 적용될까에서 먼저 볼 수 있어요.
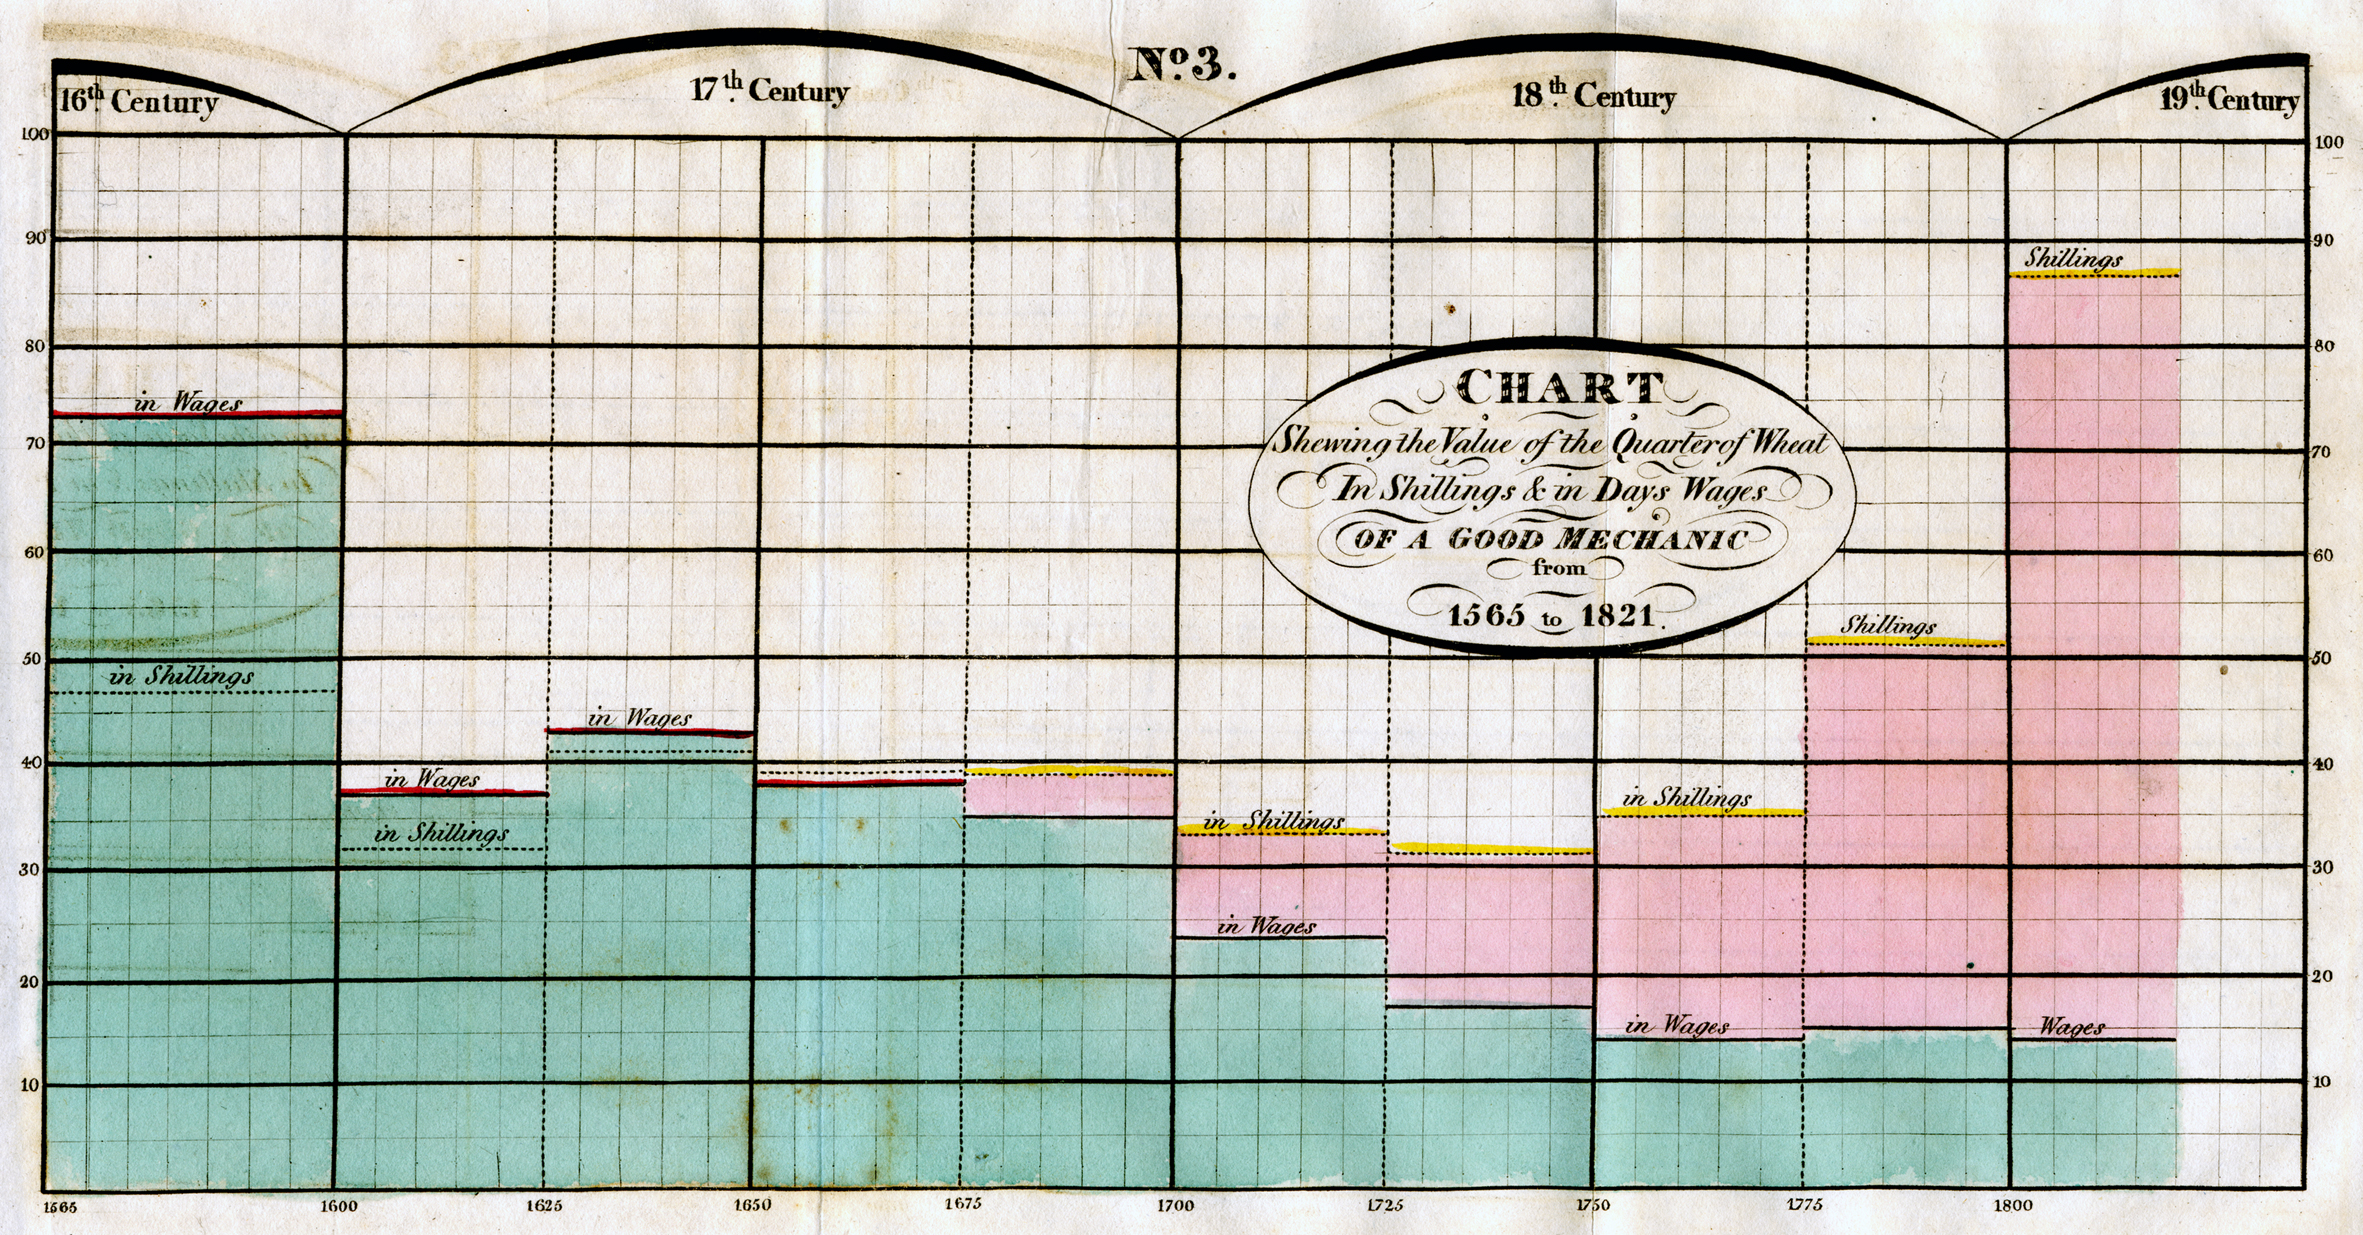
글 상단의 1821년 비교 도표는 윌리엄 플레이페어가 밀 가격과 숙련 노동자의 임금 일수를 한 화면에 놓은 퍼블릭 도메인 자료입니다. 이 자료는 BDSM 연구의 증거가 아니라, 서로 다른 양을 비교할 때 축과 단위를 먼저 읽어야 한다는 역사적 사례입니다. 원본은 Wikimedia Commons에서 확인할 수 있어요.
p값은 가설이 참일 확률을 말하지 않아요
미국통계학회(ASA)는 p값을 “정해 둔 통계 모형 아래에서 관찰된 값과 같거나 더 극단적인 자료가 나올 정도”를 나타내는 수치로 설명합니다. 출발점에는 모형과 가정이 있어요. 표본을 어떻게 뽑았는지, 어떤 변수를 선택했는지, 검정 방법이 자료에 맞는지에 따라 해석 범위도 달라집니다.
그래서 p=.03을 보고 “귀무가설이 참일 확률은 3%”라고 말할 수 없습니다. “결과가 우연으로 생겼을 확률이 3%”라는 번역도 정확하지 않아요. ASA는 p값이 연구 가설의 참·거짓 확률이나 ‘우연만으로 자료가 생겼을 확률’을 직접 측정하지 않는다고 명시합니다. 이 값만으로 연구 결론, 상담 판단, 상대에 대한 평가를 결정해서도 안 돼요.
‘유의함’과 ‘차이가 큼’은 다른 문장입니다
표본이 크면 아주 작은 집단 차이도 낮은 p값을 만들 수 있습니다. 반대로 표본이 작거나 값의 흩어짐이 크면 실제로 살펴볼 만한 차이가 있어도 불확실성이 크게 남을 수 있어요. 통계적 유의성은 차이의 크기나 생활에서의 중요도를 대신하지 않습니다.
2013년 Wismeijer와 van Assen의 연구는 BDSM 참여자 902명과 비교집단 434명의 온라인 설문을 비교했습니다. 연구진은 성격, 애착, 거절민감성, 주관적 안녕감의 여러 지표를 분석하면서 p값만 보고하지 않았어요. φ, Cramér의 V, 부분 η² 같은 효과크기를 함께 사용했고, 미리 정한 대조에는 다중검정을 고려해 α=.01을 적용했습니다. 이 방법 선택은 “유의한 항목이 있었다”보다 더 많은 정보를 줍니다. 얼마나 많은 질문을 비교했는지, 차이의 크기를 어떤 단위로 요약했는지까지 읽을 수 있기 때문이에요.
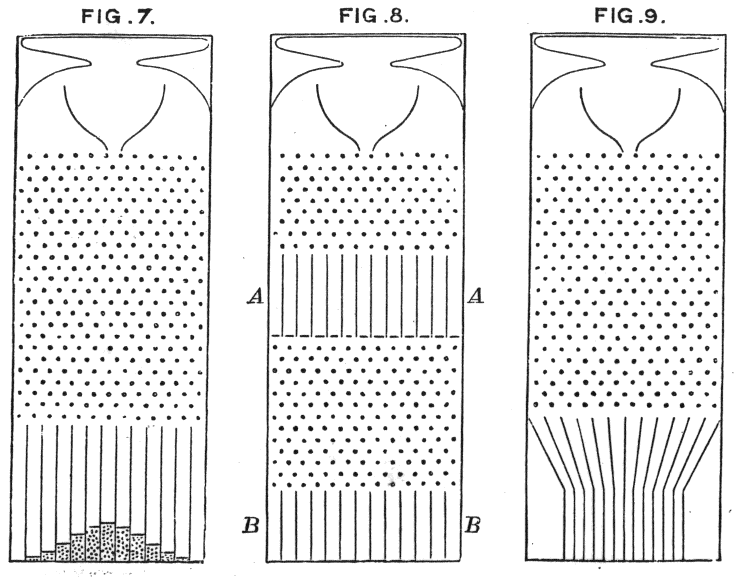
갈턴의 퀸컹크스에서 같은 출발점의 구슬도 못을 지날 때마다 서로 다른 경로를 거쳐 아래 칸에 분포합니다. 이 역사적 도해는 BDSM 연구의 증거가 아니라, 표본 통계가 하나의 숫자로 요약되기 전에는 값의 흩어짐과 분포가 있다는 점을 떠올리기 위한 자료예요.
효과크기와 신뢰구간은 무엇을 보태나요?
효과크기는 집단 차이나 변수 사이의 관련성이 어느 정도인지 공통된 방식으로 요약합니다. 지표마다 단위와 해석법이 다르기 때문에 “0.2면 언제나 작다”처럼 기계적으로 등급을 붙이면 안 돼요. 어떤 척도를 썼는지, 집단 안의 값이 얼마나 겹치는지, 그 차이가 연구 질문에서 실제로 어떤 의미를 갖는지도 함께 봐야 합니다.
신뢰구간은 추정값의 불확실성을 드러냅니다. 95% 신뢰구간을 “참값이 이 구간 안에 있을 확률 95%”라고 그대로 읽는 것은 빈도주의 계산의 뜻과 다릅니다. 같은 절차를 여러 번 반복했을 때 만들어진 구간 가운데 일정 비율이 참값을 포함하도록 설계됐다는 뜻에 가까워요. 독자에게 중요한 점은 구간의 폭과 방향입니다. 좁은 구간은 현재 자료에서 추정이 비교적 정밀하다는 단서이고, 넓은 구간은 작은 차이부터 큰 차이까지 여러 값이 자료와 양립할 수 있음을 보여 줍니다.
차이의 평균과 구간을 읽어도 개인을 분류할 수는 없습니다. 두 집단 평균이 달라도 분포가 크게 겹칠 수 있고, 한 사람의 응답에는 연구가 측정하지 않은 맥락이 남아요. 집단 효과크기를 개인의 성향, 동의 능력, 정신건강을 예측하는 점수로 바꾸면 연구가 답하지 않은 질문을 덧붙이게 됩니다.
비교를 많이 할수록 ‘우연히 낮은 값’을 만날 기회도 늘어요
성격 다섯 요인, 여러 애착 지표, 안녕감, 하위집단을 한꺼번에 비교하면 검정 횟수가 빠르게 늘어납니다. 각 검정을 따로 p<.05로 판단하면 전체 분석에서 적어도 하나의 낮은 값이 우연히 나타날 가능성도 커져요. NIST 통계 핸드북이 모든 쌍을 단순히 반복 비교해서는 전체 유의수준이 유지되지 않는다고 설명하는 이유입니다.
논문을 읽을 때는 분석을 미리 정했는지, 다중비교를 어떻게 다뤘는지, 예상과 다른 결과까지 보고했는지 확인하세요. 결과를 본 뒤 유리한 변수만 남기거나, 여러 분석 중 가장 낮은 p값만 제목에 올리면 독자는 전체 선택 과정을 볼 수 없습니다. “보정했다”는 단어 하나도 충분하지 않아요. 어떤 비교 묶음에 어떤 방법을 적용했는지가 필요합니다.
반복 연구는 복사 시험이 아니라 새 자료와의 대조예요
2025년 발표된 Lecuona 등의 연구는 스페인 표본 1,907명을 이용해 2013년 연구의 성격·애착·거절민감성·안녕감 결과를 가깝게 반복했습니다. 새 연구는 효과크기와 구조적 불변성, 성적·성별 소수자 구성과 다른 역할 분류의 영향을 함께 살폈고, 여러 결과가 앞선 연구와 비슷한 방향을 보였다고 보고했어요.
이 결과는 앞선 논문과 같은 제목의 결론이 한 번 더 나왔다는 뜻보다, 다른 나라와 새 표본에서 어떤 부분이 다시 관찰됐는지를 볼 자료에 가깝습니다. 두 연구의 모집 경로, 집단 구성, 척도와 분석 차이를 함께 읽어야 해요. 반복된 집단 경향도 특정 개인에게 그대로 적용되는 법칙은 아닙니다.
연구 기사에서 확인할 여섯 문장
- 이 p값은 어떤 모형과 어떤 비교에서 계산됐는가?
- 효과크기는 무엇이며, 값의 실제 단위와 집단 간 겹침은 어떠한가?
- 신뢰구간은 얼마나 넓고, 해석상 중요한 여러 값이 함께 들어 있는가?
- 검정한 변수와 하위집단은 몇 개이며, 다중비교를 어떻게 다뤘는가?
- 처음부터 정한 분석과 자료를 본 뒤 탐색한 분석을 구분했는가?
- 새 표본의 반복 연구와 다른 방법의 연구가 비슷한 결론을 지지하는가?
이 질문 가운데 답을 찾지 못했다고 논문이 곧 틀렸다고 판정할 필요는 없습니다. 다만 제목보다 강한 결론을 만들어 내지 않는 편이 맞아요. “이 표본과 이 분석에서 차이가 관찰됐다”와 “BDSM에 관심 있는 사람은 원래 이런 성격이다” 사이에는 효과크기, 불확실성, 표본의 대표성, 반복 가능성이라는 여러 단계가 남아 있습니다.
BDSM 관심 자체와 임상 진단을 구분하려면 ICD-11이 관심·고통·위험을 나누는 기준도 함께 읽어 보세요. 통계적 차이는 진단 기준이 아니며, 유형명이나 집단 평균은 현재의 동의와 개인적 경계를 대신하지 않습니다.
이 글은 연구 결과를 읽기 위한 일반적인 심리교육 자료이며 개인의 성향이나 정신건강 상태를 진단하지 않습니다.
참고 자료
- American Statistical Association (2016), Statement on Statistical Significance and P-Values — p값의 의미와 오해를 정리한 여섯 원칙.
- NIST/SEMATECH e-Handbook, Multiple Comparisons — 여러 평균·비율을 비교할 때 전체 오류율을 따로 다뤄야 하는 이유.
- Wismeijer & van Assen (2013), Psychological Characteristics of BDSM Practitioners — 표본, 효과크기와 다중검정 처리의 실제 예.
- Lecuona 등 (2025), Not Twisted, Just Kinky — 스페인 표본을 사용한 가까운 반복 연구.